散在する社内文書を
ナレッジベースに集約します
コネクターが社内システムの文書を定期的に取り込み、インデックスを作成します。管理者画面でコネクターを登録すると、取り込みとインデックス作成が自動で行われます。Confluence・Jira・Slack・Box・Dropboxなどでは、文書ごとに元のシステムのアクセス権限をそのまま適用するよう設定できます。
散在する社内文書を
ナレッジベースに集約します
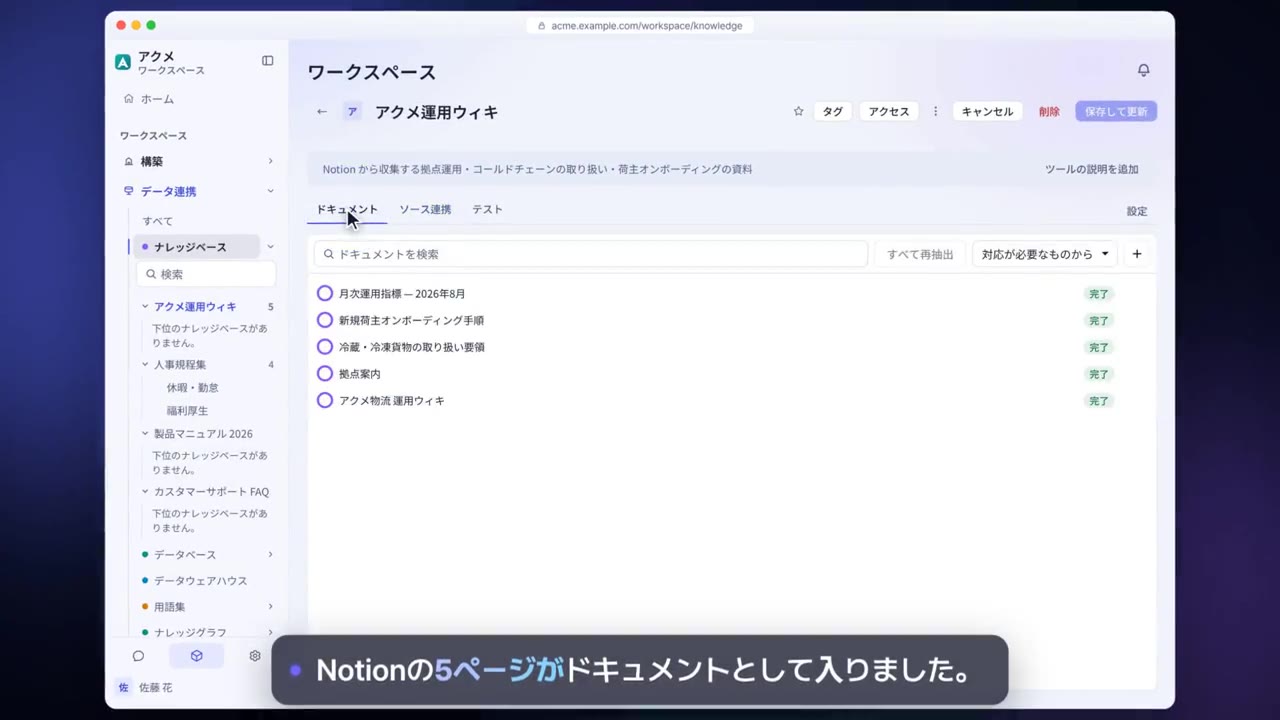
コネクターが社内システムの文書を定期的に収集し、インデックスを作成します。エージェントはこの文書を根拠に回答し、文ごとに出典を表示します。
 Syncgate
分野別のコネクターとソース権限
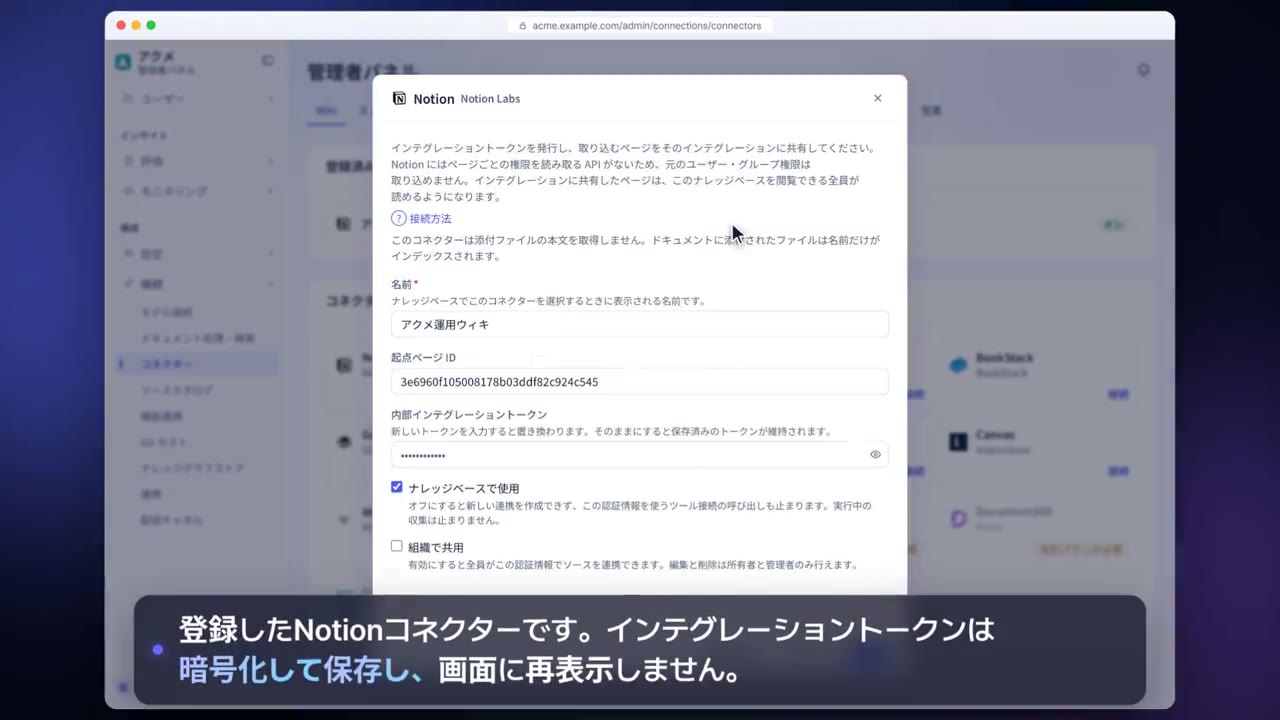
管理者画面でコネクターを登録すると、収集とインデックス作成が自動で行われます。認証トークンは暗号化して保存します。Confluence・Jira・Slack・Box・Amazon S3 などでは、文書ごとに元のシステムのアクセス権限をそのまま適用するよう設定できます。
導入前後の比較
必要な文書が、Wiki・ドライブ・メッセージング・チケットに分散しています。
38種類のドキュメントソースをコネクターで連携し、ナレッジベースでまとめて検索します。
文書をAIで使うには、別途コピーしてアップロードする必要があります。
文書は元の場所に置いたまま、定期的に取り込んでインデックスを作成します。
PDFの表やスキャンした文書は、正しく読み取れません。
抽出エンジンと処理プロファイルで、文書の種類に合わせて読み取ります。
4ステップの流れ
ソースカタログから連携するシステムを選び、認証情報を入力します。認証トークンは暗号化して保存します。
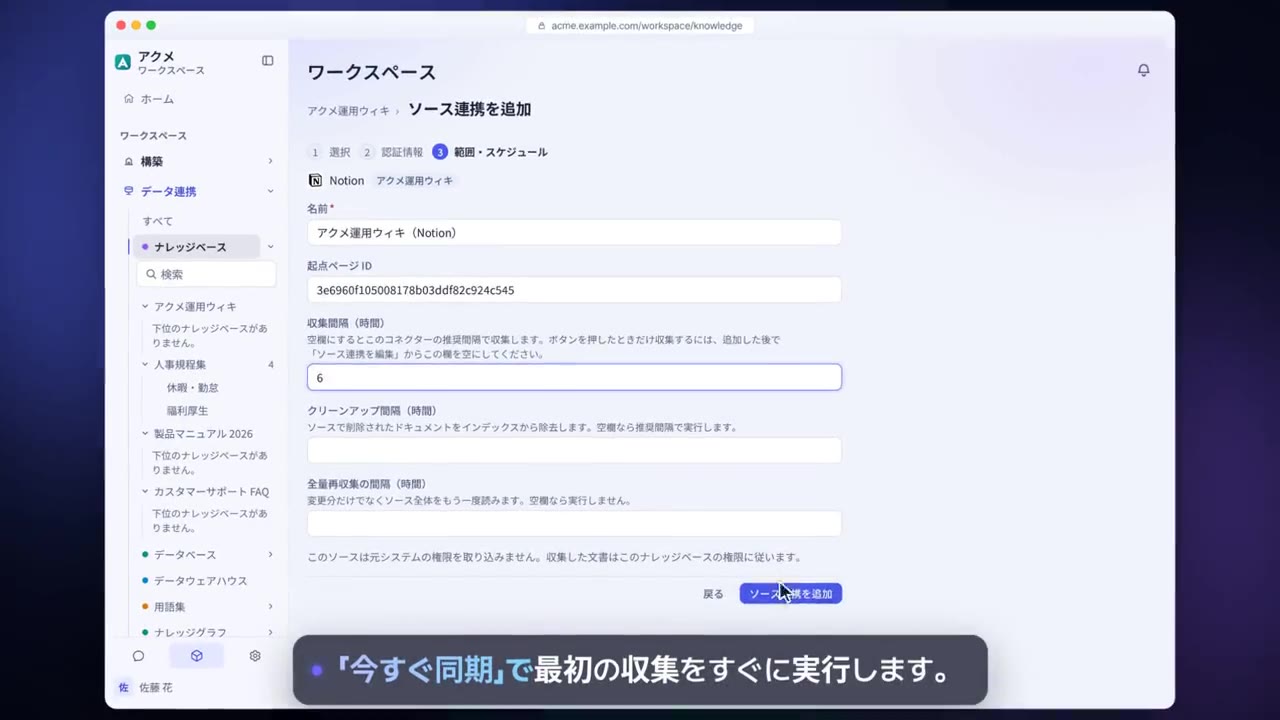
取り込むスペース・フォルダ・チャンネルと、取り込みの間隔を設定します。
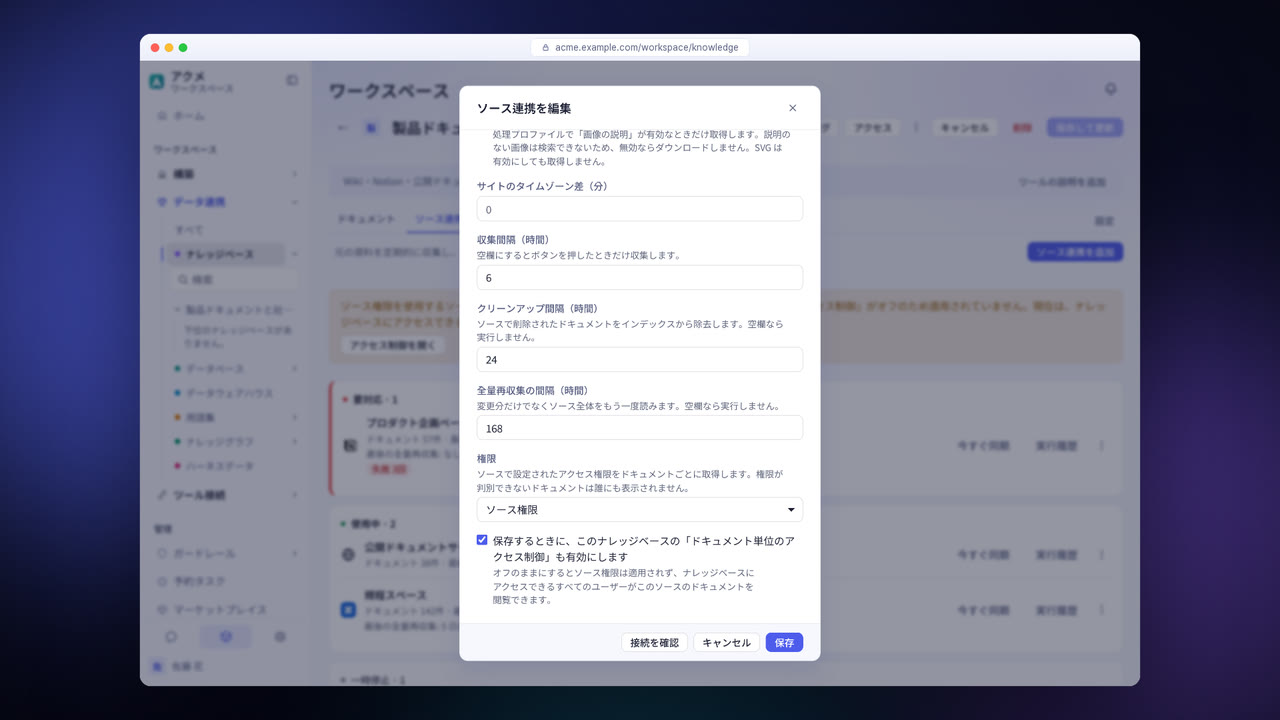
Confluence・Jira・Slack・Box・Dropboxなどでは、ソースのアクセス権限をそのまま適用するかどうかを設定します。そのほかのソースは、ナレッジベースの権限に従います。
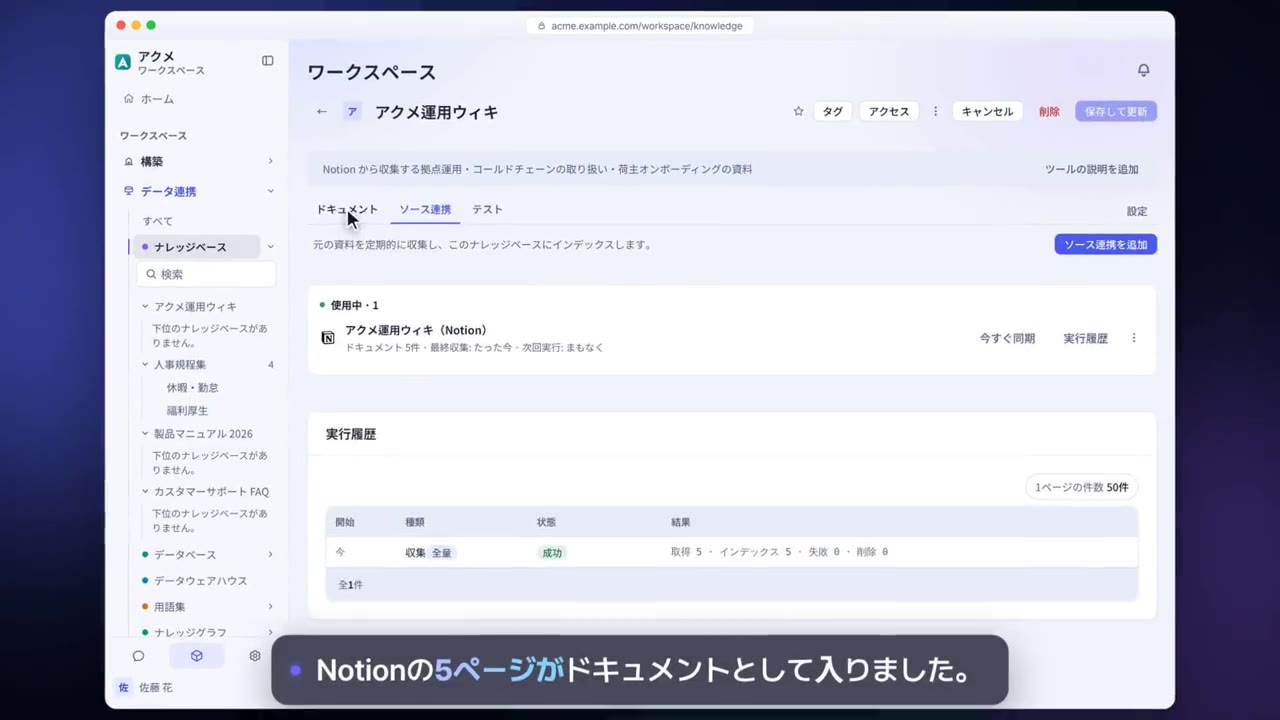
「ソース連携」タブで、連携の状態と実行履歴を確認します。
ドキュメント連携の詳細機能
38種類のドキュメントソース
Wiki・ストレージ・メッセージング・チケット・プロジェクト・開発・メール・Web・公共データ・研究の各分野のドキュメントソースを連携します。
ソースの例
Confluence・Notion・Google Drive・Box・Slack・Jira・GitHub・Gmail・Amazon S3などを連携します。
公共・研究分野のソース
Open DART・SEC EDGAR・韓国の公共データポータル(data.go.kr)・Europe PMCの資料を取り込みます。
ソース権限の適用
Confluence・Jira・Slack・Box・Dropbox・Amazon S3・Google Cloud Storage・Azure Blob Storage・GitLabのコネクターは、文書ごとにソースシステムの権限に従うよう設定できます。
抽出エンジン・処理プロファイル
文書の種類に合わせて、テキスト・表・画像の読み取り方法を設定します。
データ抽出ハーネス
ナレッジベースで読み取れないファイルは、ハーネスが読み取ってインデックスを作成します。
企業ごとの設定項目
- コネクターを登録し、認証情報を入力します。
- 取り込みの間隔と範囲を設定します。
- 文書の種類ごとに処理プロファイルと抽出エンジンを設定します。
数値は2026年10月時点の製品にもとづいています。
ドキュメント連携に関するよくある質問
文書のコピーを保存しますか?
インデックス作成に必要な内容を取り込んで検索できるようにし、元の文書は元のシステムにそのまま残します。
ソースで削除した文書はどうなりますか?
次回の取り込み時に、ソースに存在しない文書をナレッジベースから削除します。
連携できるソースの一覧を事前に確認できますか?
はい。導入のご相談の際にソースの一覧をご覧いただけます。実際の文書の一部を連携して、ご確認いただくことも可能です。
自社の文書で
実際にお試しください
導入のご相談では、社内文書の一部を連携して実際の回答品質をご確認いただけます。ご質問をお寄せいただければ、担当者よりご連絡いたします。